ai
H100 한 장으로 사내 LLM을 돌리면 몇 명이 쓸 수 있을까
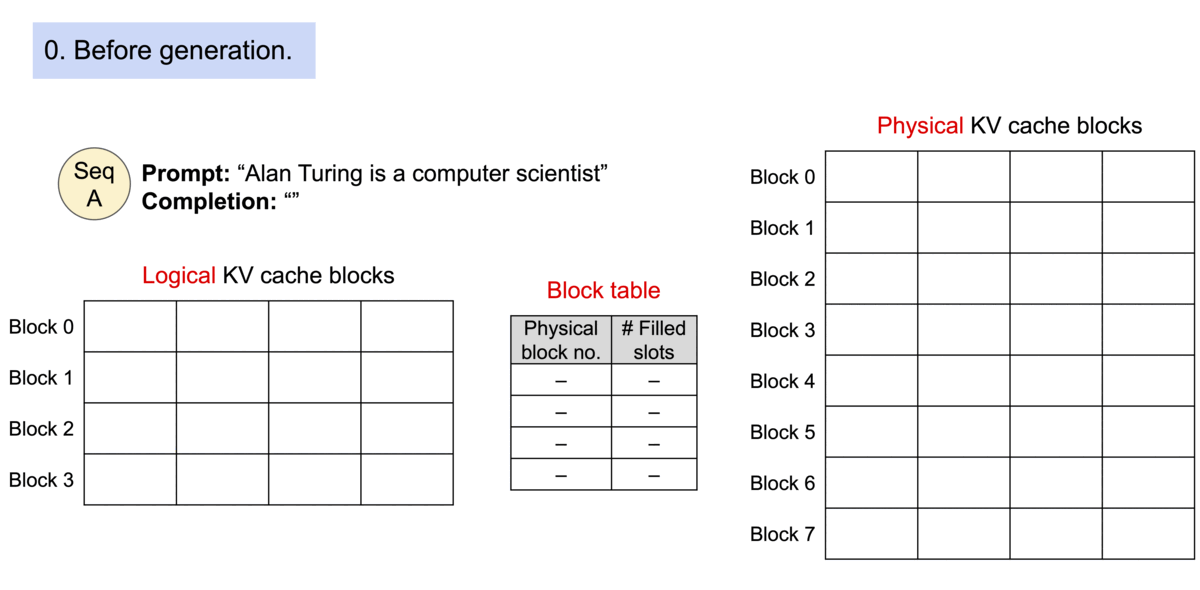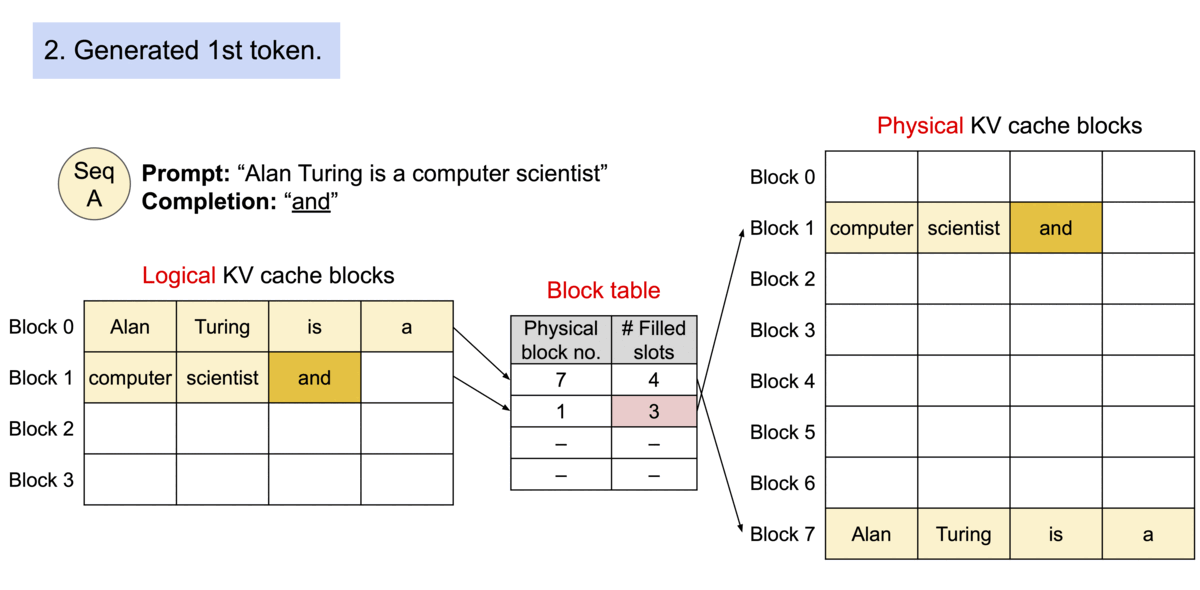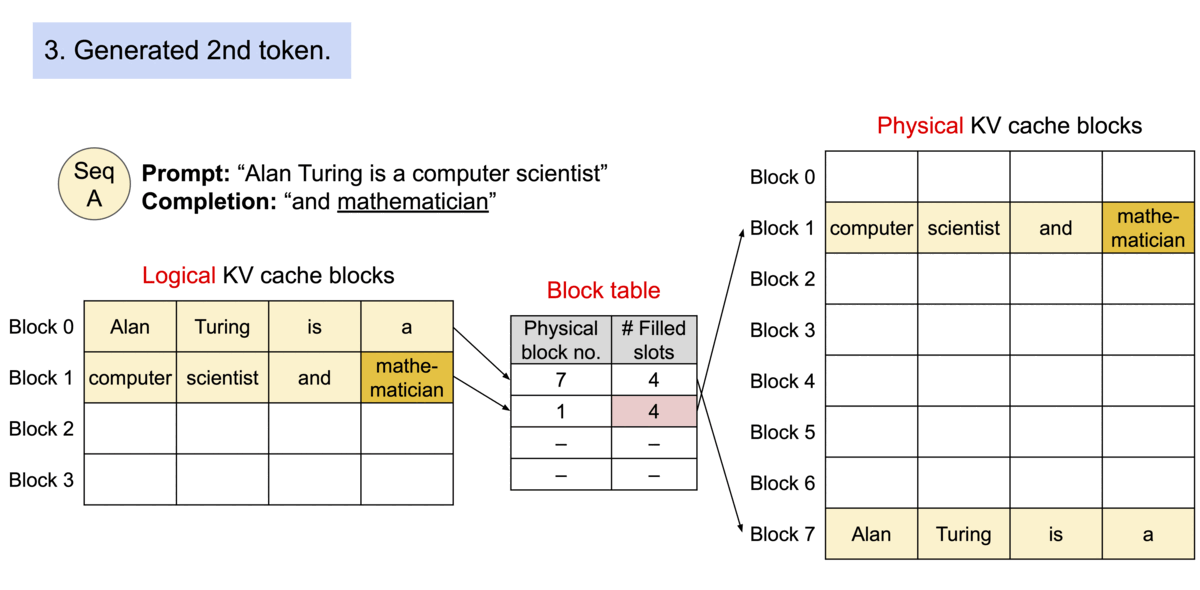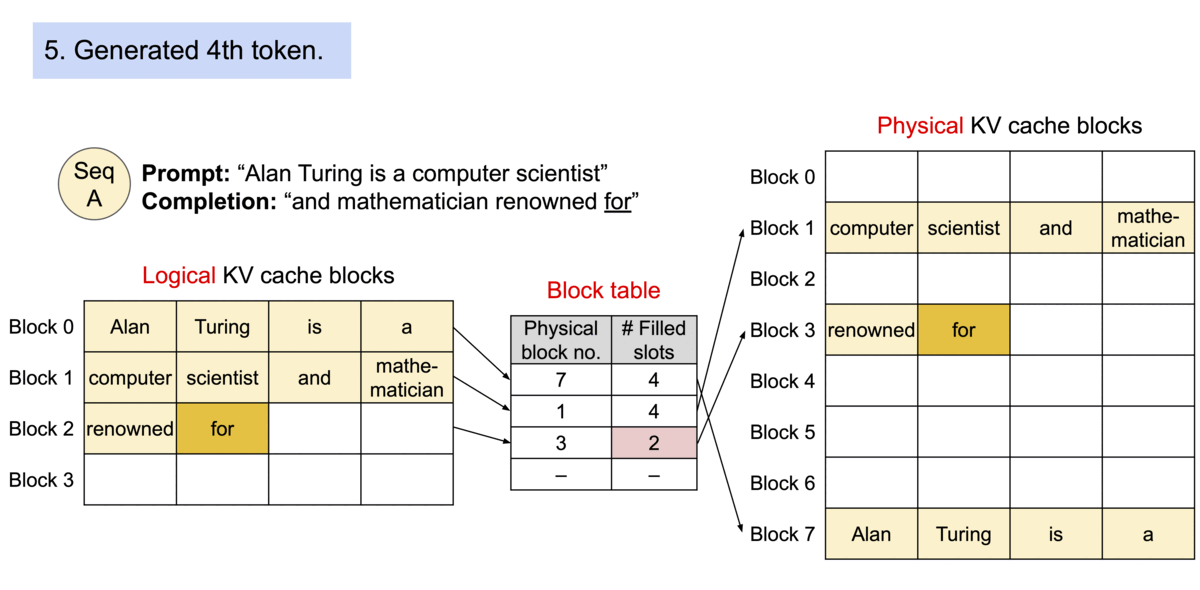
모델 가중치와 KV 캐시 크기만 알면 GPU 한 장이 동시에 받을 수 있는 요청 수를 꽤 정확하게 어림할 수 있습니다. Qwen3-32B와 H100 80GB로 직접 계산해 봤습니다.
자세히 보기→
AI 기술 트렌드와 실전 인사이트
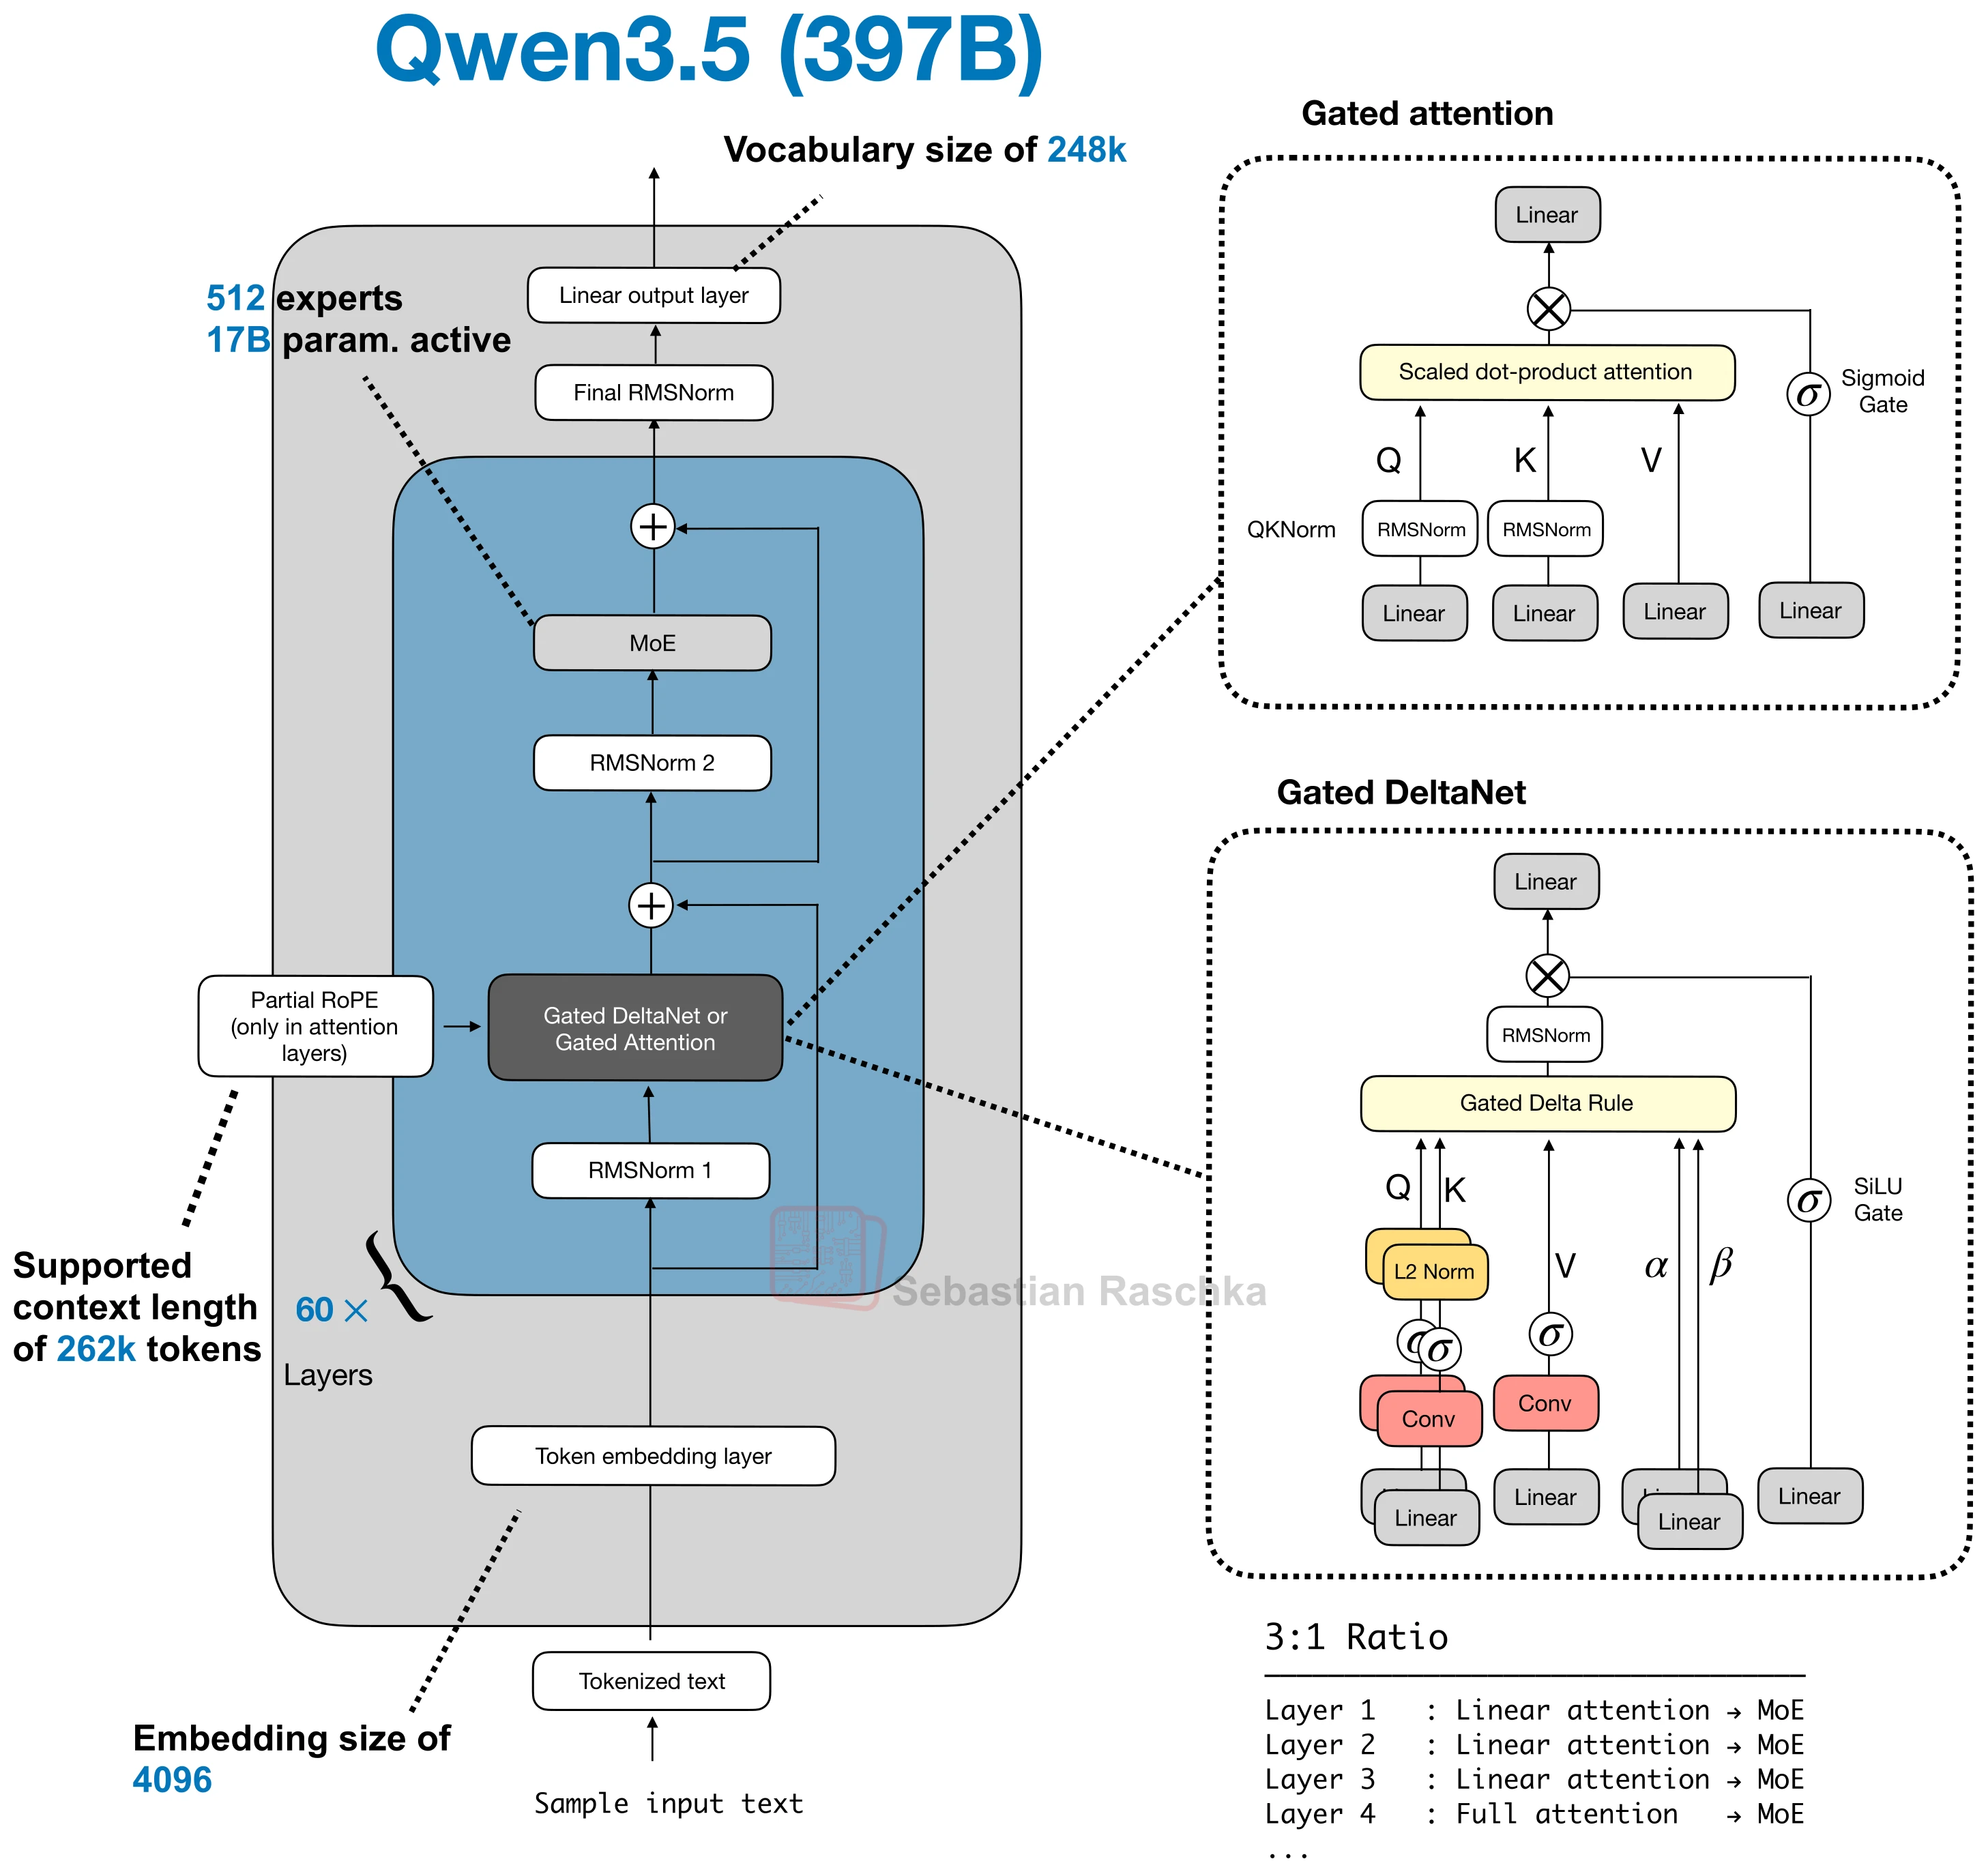
GPT-OSS, Gemma 3, Qwen 3.5, Nemotron 3 Super를 아키텍처, 벤치마크, 비용, 한국어 지원 기준으로 비교하고 상황별로 어떤 모델이 맞는지 정리했습니다. 수치는 각 모델의 공식 자료로 확인했습니다.
Google Research의 TurboQuant는 무작위 회전과 1비트 QJL 보정으로 KV 캐시를 3비트 남짓까지 줄입니다. 블로그와 논문이 말하는 수치가 어떻게 다른지까지 원문 기준으로 정리했습니다.